Photo by <a href="https://unsplash.com/@jkoblitz?utm_source=WP+Agent&utm_medium=referral">Julia Koblitz</a> on <a href="https://unsplash.com/?utm_source=WP+Agent&utm_medium=referral">Unsplash</a>
DI išbandytas su 100 tikros laboratorijos užduočių: rezultatai atskleidė rimtas klaidas

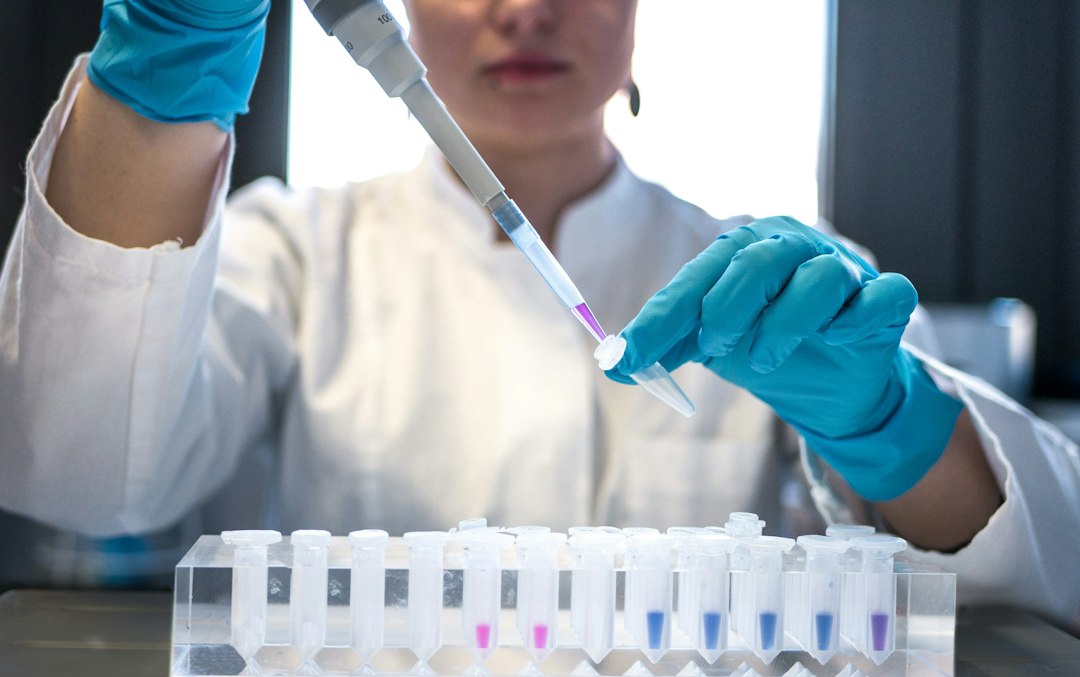
Ar dirbtinis intelektas gali ne tik apibendrinti mokslinį straipsnį, bet ir teisingai įvertinti tai, ką mokslininkas mato tikroje laboratorijoje? Lapkričio 6 d. „OpenAI“ kartu su biotechnologijų bendrove „Ligo“ pristatė „BioBasicsBench“ – 100 praktinių biologijos laboratorijos užduočių rinkinį. Jo tikslas – patikrinti, ar DI agentai geba išanalizuoti nepatogius, triukšmingus ir kartais klaidinančius eksperimentų rezultatus.
REKLAMA
Tai gerokai skiriasi nuo įprasto klausimų testo. Vertinime naudojamos tikros gelio nuotraukos, mikroskopo vaizdai, laboratoriniai užrašai, lentelės, prietaisų rodmenys, genetinės sekos ir trumpi eksperimentų vaizdo įrašai. Tokie duomenys dažnai nėra tvarkingi, o neteisingai suprastas vienas signalas gali sugriauti visą vėlesnę išvadą.
Rezultatai nevienareikšmiai. Didelio samprotavimo režimu „GPT-6 Astra“ vidutiniškai surinko 66,7 proc. galimų vertinimo balų, o „GPT-5.6 Sol“ – 43,8 proc. Tai rodo pažangą šiame konkrečiame teste, tačiau tikrai nereiškia, kad naujasis modelis teisingai atliktų du trečdalius visų įmanomų laboratorinių darbų ar galėtų savarankiškai vadovauti medicinos tyrimams.
Mokslui svarbu mokėti pasakyti „nežinau“
Testo autoriai pabrėžia, kad teisingas atsakymas nebūtinai yra tiksliai apskaičiuotas skaičius. Kartais svarbiau suprasti, kad eksperimento kontrolė netinkama ir iš duomenų išvados daryti negalima. Pavyzdžiui, viename bandyme ankstesnis modelis rėmėsi neigiamo kontrolinio mėginio rezultatu, nors kontrolė buvo pažymėta neteisingu antibiotiku. Pažangesnis modelis šią problemą pastebėjo.
Naujausi straipsniai
JAV Pentagono planas: 250 mln. dolerių baterijų gamybai, kad dronai mažiau priklausytų nuo importo
ES ir Indija baigė derybas dėl 93,5 mlrd. eurų tyrimų programos: kas keisis Europai?
„OpenAI“ pasitelkė įsilaužimų tyrėjus „Hacktron“: DI sistemų saugume tikrins silpniausias jungtis
Kitoje užduotyje DI analizavo fluorescencinius mikroskopo vaizdus. Vieno kanalo šviesos signalas iš dalies sutapo su kito, todėl vien vaizdo ryškumas negalėjo patikimai įrodyti ląstelės būklės. Būtent tokie niuansai atskiria paprastą paveikslėlio atpažinimą nuo tikro mokslinio interpretavimo. Modeliui reikia suprasti ne tik matomą objektą, bet ir eksperimento sąlygas.
Tačiau testas atskleidė ir akivaizdžių trūkumų. Kai kuriuose pavyzdžiuose pažangus modelis neteisingai skaičiavo bakterijų kolonijas, praleido gretimus objektus arba pažymėjo tuščias vietas. Vieno mėginio vertinimo paklaida siekė maždaug 12 procentų. Laboratorijoje toks nukrypimas gali turėti tiesioginės įtakos kiekybiniams skaičiavimams ir vėlesniems sprendimams.
REKLAMA
Ką tai reiškia ligų tyrimams
Biologijos tyrimai susiję su didžiuliu skirtingų duomenų kiekiu. Mokslininkai nuolat lygina vaizdus, matavimus, bandinių žymėjimą ir kontrolinius mėginius. Jei DI sugebės patikimai atlikti rutinines analizes, tyrėjai teoriškai galės daugiau laiko skirti eksperimentų planavimui ir hipotezėms. Vis dėlto tokia nauda atsiras tik tada, kai sistemų kokybė bus tikrinama nepriklausomai ir realiomis darbo sąlygomis.
„BioBasicsBench“ sudaro užduotys iš penkių sričių: baltymų tyrimų, vaizdinimo ir ląstelių analizės, matavimų, nukleorūgščių metodų bei molekulinio klonavimo. Modeliai atliko 18 500 vertinimo bandymų įvairiais nustatymais. Užduočių vertinimą rengė specialistai, o darbai buvo peržiūrėti ir kitų laboratorijų mokslininkų, kad testas nebūtų vien automatiškai sugeneruotų klausimų rinkinys.
Tokie eksperimentai ypač aktualūs Lietuvai, kur gyvybės mokslų ir biotechnologijų sektorius yra vienas svarbių aukštųjų technologijų ekonomikos segmentų. Vis dėlto iš vieno DI modelių testo negalima spręsti, kad laboratorijose netrukus išnyks žmogaus specialisto poreikis. Vertingiausia pažanga būtų sistema, kuri ne tik pasiūlo atsakymą, bet ir aiškiai parodo, kur jos įrodymų nepakanka.
REKLAMA
Panašias technologijų ribų problemas esame nagrinėję rašydami apie robotų atminties klaidų aptikimą, skaitmeninių smegenų modeliavimą ir naujų skaičiavimo sistemų bandymus.
Naujasis tyrimas parodo paradoksą: DI vis geriau susidoroja su sudėtingais duomenimis, bet kartais klysta dėl smulkmenų, kurias apmokytas laborantas pastebėtų iš karto. Būtent todėl jo nauda mokslui priklausys ne vien nuo modelio dydžio, bet ir nuo disciplinos, kaip jo rezultatai tikrinami.
Vienas įdomiausių metodinių sprendimų – užduočių vertinimas ne vien pagal galutinį teiginį. Ekspertai parengė atskirus kriterijus, pagal kuriuos buvo galima atskirti teisingą matavimą, pagrįstą išvadą ir klaidingą interpretaciją. Tai leidžia matyti, kurioje mokslinio darbo stadijoje modelis klysta: ar neteisingai skaito vaizdą, ar ignoruoja kontrolinį mėginį, ar pateikia pernelyg užtikrintą atsakymą, kai informacijos nepakanka.
Toks testavimas svarbus ir platesnei DI diskusijai. Laboratorijos pavyzdyje klaida nebūtinai akivaizdi iš teksto sklandumo: net labai įtikinamai skambantis paaiškinimas gali remtis netinkamai pažymėtu mėginiu. Dėl to tyrėjams reikia turėti galimybę patikrinti agento naudotus duomenis, atkartoti sprendimo eigą ir sustabdyti analizę, kai pritrūksta įrodymų. Tai ypač svarbu ruošiant metodikas, kurios vėliau būtų taikomos sveikatos tyrimams.
Galiausiai reikia skirti testo rezultatą nuo sertifikavimo. Net jei modelis gerokai pagerino rezultatą, „BioBasicsBench“ nėra reguliuotojo suteiktas leidimas naudoti jį klinikinėse procedūrose. Tai tyrimų priemonė, padedanti palyginti sistemas ir nustatyti silpnąsias vietas.
Šaltinis: pirminis oficialus pranešimas.
Kaip vertinate šį straipsnį?
NAUJIENOS IŠ INTERNETO
Prenumeruokite mūsų „YouTube“ kanalą ir mėgaukitės įdomiais vaizdo reportažais apie mokslą ir technologijas.
Trumpai, aiškiai ir be triukšmo – gaukite svarbiausias technologijų ir mokslo naujienas pirmieji.
1 700+ narių jau seka mūsų puslapį, laukiame tavęs!
DIENOS SKAITOMIAUSI
1
Ukraina pirmą kartą užsakė daugiau nei 2 000 karinių bagių: konkurse sutaupė 1,5 mlrd. grivinų
2Latvijoje išbandyta nauja apsauga nuo dronų: „Anduril“ ir „ORIGIN“ sistemas sujungė per 4 dienas
3IBM ir AMD sujungė kvantinį procesorių su superkompiuteriu: sieks išspręsti didžiausią klaidų problemą
4Ukraina per mėnesį atliko 31 398 misijas antžeminiais robotais: karo logistikoje įvyko lūžis
5Europos zondas nufotografavo asteroidą vos iš 60 km: mokslininkai išvydo nematytą jo pusę
NAUJAUSI
10
Taip pat skaitykite
Atrinkome panašius straipsnius, kurie gali jums patikti.
Gynyba Ir Saugumas
JAV Pentagono planas: 250 mln. dolerių baterijų gamybai, kad dronai mažiau priklausytų nuo importo
TechNaujienos.lt | 2026-11-08
Mokslas Ir It
ES ir Indija baigė derybas dėl 93,5 mlrd. eurų tyrimų programos: kas keisis Europai?
TechNaujienos.lt | 2026-11-08
Kibernetinis Saugumas
„OpenAI“ pasitelkė įsilaužimų tyrėjus „Hacktron“: DI sistemų saugume tikrins silpniausias jungtis
TechNaujienos.lt | 2026-11-08
Dirbtinis Intelektas
„Meta“ pristatė „Muse Spaces“: DI leidžia susikurti asmeninę programėlės erdvę paprastu prašymu
TechNaujienos.lt | 2026-11-08
Kosmosas
NASA ieško naujų astronautų kelionėms į Mėnulį ir Marsą: paskelbė reikalavimus ir terminą
TechNaujienos.lt | 2026-11-08
Verslas Ir Technologijos
„Fox“ užbaigė „Roku“ įsigijimą: daugiau kaip 100 mln. namų ūkių pasiekianti platforma keičia savininką
TechNaujienos.lt | 2026-11-08
Gynyba Ir Saugumas
Britanija atskleidė naują karinį palydovą „Titania“ ir orbitinių grėsmių stebėjimo planą
TechNaujienos.lt | 2026-11-08
Kosmosas
NASA Mėnulio bazei numatė iki 10 mlrd. dolerių sutarčių: pristatė ir branduolinį robotą
TechNaujienos.lt | 2026-11-08
Verslas Ir Technologijos
„Nvidia“ ir „Anthropic“ žengia į kelionių verslą: „Amadeus“ atskleidė naują DI strategiją
TechNaujienos.lt | 2026-11-07
Kosmosas
Europos zondas nufotografavo asteroidą vos iš 60 km: mokslininkai išvydo nematytą jo pusę
TechNaujienos.lt | 2026-11-07